AI唱歌动画怎么做视频?歌词分镜加数字人唱歌出片
更新时间:2026-11-16 16:29:47 发布时间:13小时前 阅读:12次AI唱歌动画怎么做视频?核心是歌词分镜加数字人唱歌:贴歌词、选风格、点生成歌曲,识别字幕对齐时间,定人物场景、逐镜出图,视频段选数字人唱歌,末了合成导出。前三步定像不像 MV,后三步定唱得对不对,口型跟字幕走。
打开AI唱歌动画工具,歌词、分镜、数字人唱歌都在同一个项目里,做完直接合成出片。
歌词结构与镜头节奏对齐
AI唱歌动画的歌词按镜头写
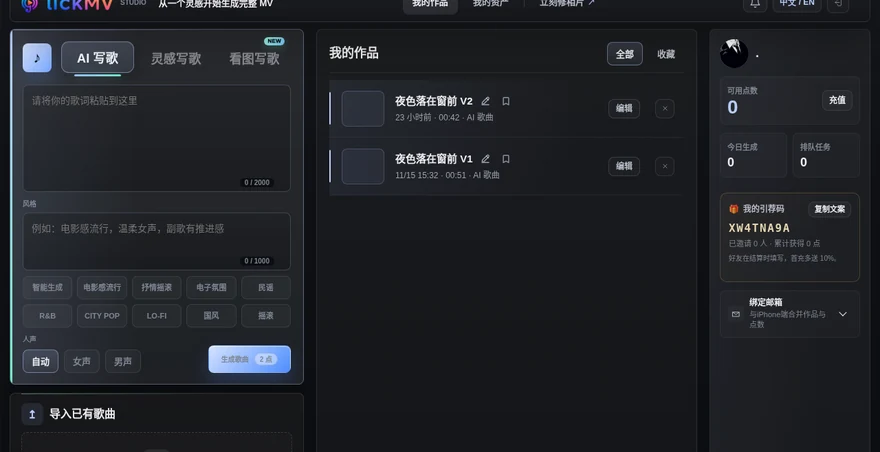
歌词框容 2000 字,看着宽,实际只够一首完整歌。写的时候按镜头切:一句词一个画面,句子长度就是镜头长度。七到十二字一句,四到八句一段,主歌铺陈,副歌收。写抽象情绪,分镜阶段没有画面可拆;写具体动作和场景,每一句都能落成镜头。
生成和导入,选一个入口
生成:歌词贴进去,风格框补 1000 字以内的曲风和人声描述,人声挑自动、女声或男声,点生成歌曲。导入:MP3、AAC、WAV、FLAC、M4A 都收,提交后免费识别字幕。生成耗点数,导入不耗,声音已经有就用导入。
字幕时间轴决定口型同步
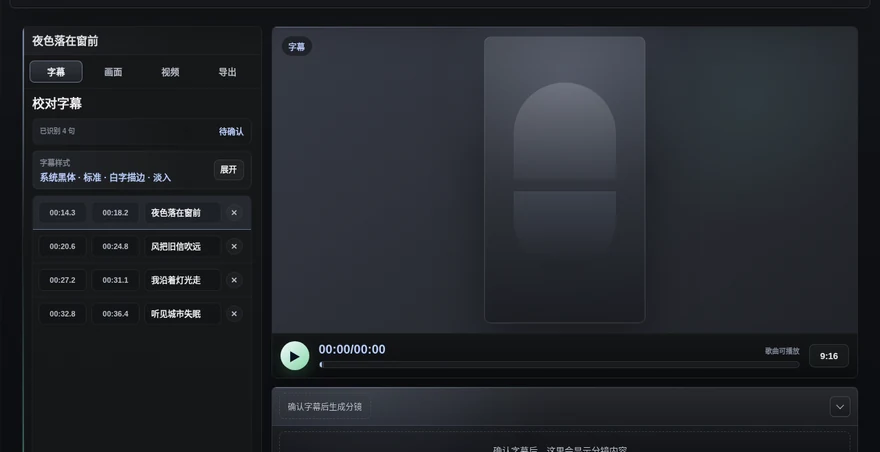
歌进项目后,系统跑一遍识别,把每句词按起止时间排进字幕栏。字幕错位,后面口型全跟着错。错字改掉,一句太长拆两句各填时间,漏句补上。句子边界对不上鼓点,会跳字。时间轴精确到 0.1 秒,例 00:14.3 到 00:18.2,手填别写整秒。
样式只动四组参数
字体、大小、描边、入场四组。字选系统黑体,描边白字加暗边,入场用淡入。其余参数不要动,跳字、旋转、花体在大屏和竖屏都会糊。样式定完全片统一,单句改样式,成片会闪。
分镜阶段锁定人物与场景
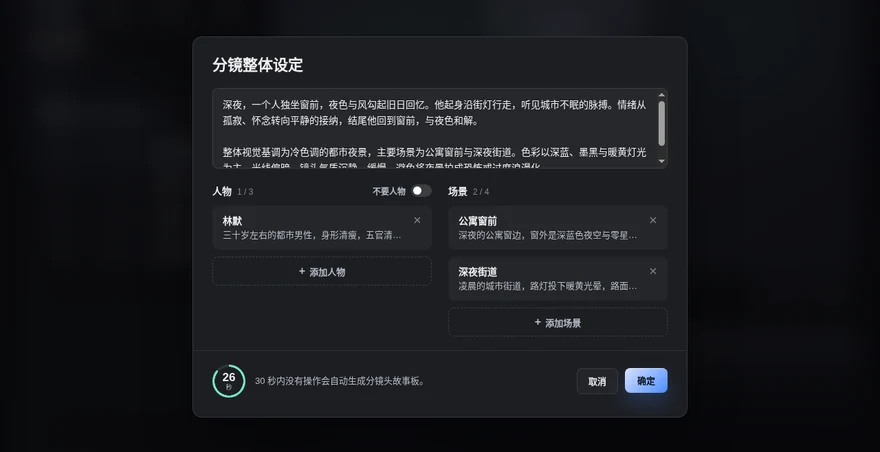
确认字幕会弹分镜设定,要两样东西:人物和场景。人物三格,场景四格,还有一段按歌词生成的剧情概述。这段概述是自己改的,不是模型改的,改完点确定,30 秒不动会自动按默认生成故事板。
人物三格写什么
年龄、身形、衣着、气质,四样写全。例:三十岁上下的都市男性,身形清瘦,深灰针织衫配黑裤,气质沉静。写死这四样,每个镜头的脸才一致;只写“一个男人”,十张图能出十个脸。
场景四格写什么
时间、地点、光源、氛围。深夜、公寓窗前、暖黄台灯、安静。场景不用多,两三个够了,同一场景在不同镜头里复用,观众才认得出是同一支 MV 的同一个夜晚。
逐镜出图的角色一致性控制
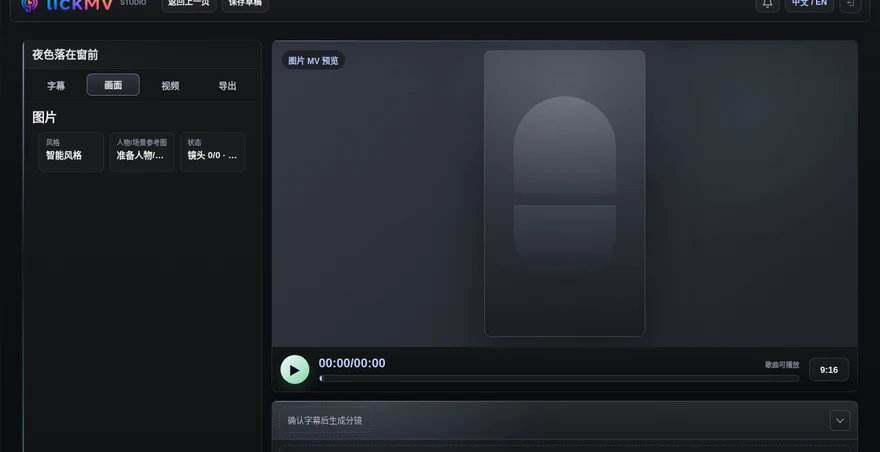
画面定 AI唱歌动画的成片像不像 MV,按分镜一镜一图。风格挂智能风格;人物参考图挂正脸半身,场景参考图挂主场景,同一场景的多镜只挂一次。状态栏显示镜头数和提示词数,对不上就补。出图盯小图,糊了单张重生成,人物脸跑了就换参考图重挂。
AI唱歌动画的数字人档位取舍
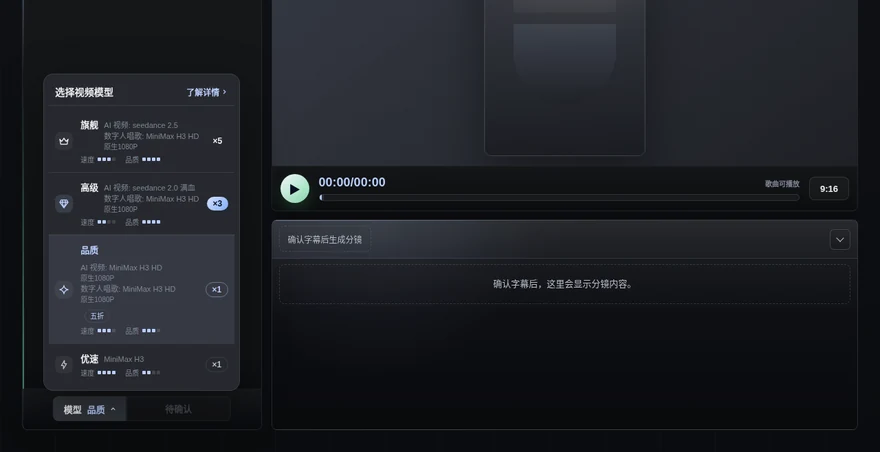
视频步骤开头选模型,四档都写明了带不带数字人唱歌。旗舰档:视频 seedance 2.5,唱歌 MiniMax H3 HD,五倍点;高级档:seedance 2.0 满血,三倍点;品质档:MiniMax H3 HD,五折。
口型对不上的三个原因
- 字幕时间轴错位,回去改字幕
- 人物嘴部被手、头发、话筒挡住
- 镜头是大侧脸,嘴部像素不够
成片合成与工程导出
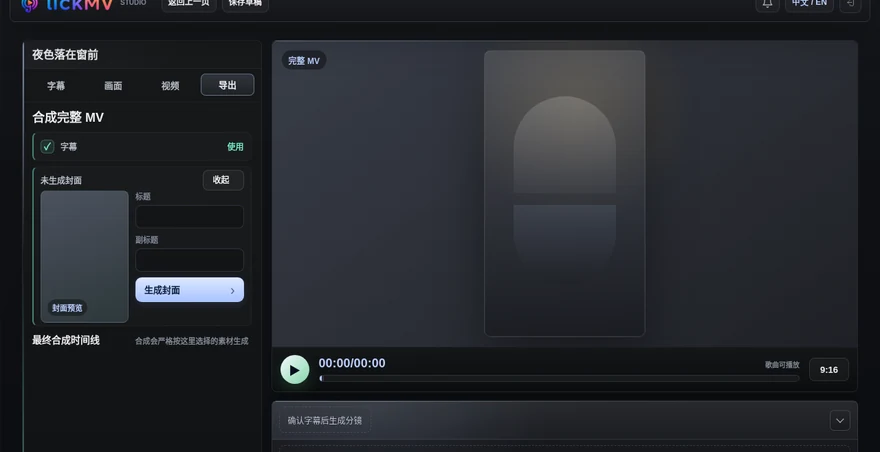
导出步骤排最终时间线:字幕勾使用,时间线按歌词顺序核一遍,点生成完整 MV 等合成。封面要单独生成,填标题和副标题,点生成封面,标题别太长,竖屏主图字超过两行会被裁。要自己改,下载剪映工程,字幕和轨道都在。
AI唱歌动画常见问题
AI唱歌动画的歌词和分镜怎么对上
一句词一个镜头。写词时定好三幕:开头铺场景,中段推进,结尾收情绪。句子超过十二字就拆,拆完每句还能落成一个画面,分镜就不会缺镜头。三幕分好,镜头数就定了,别边写边改结构。
AI唱歌动画口型对不上怎么办
字幕对不上,换正脸也白搭。查时间轴,查遮挡和角度。字幕错位是主因,改完字幕要重新生成视频段;嘴被挡住或大侧脸,换正脸头肩景重出。整段都对不上,把那段拆成两句单独生成。
AI唱歌动画一首歌要多久
40 秒的歌,字幕几分钟,分镜十几秒出,画面按镜头数排队,视频段按句数排队,半小时上下。画面和视频段都扣点数,一条 4 秒至少 1 点,试一段能过,才铺全片。
AI唱歌动画能用自己的歌吗
能。导入已有歌曲,提交后免费识别字幕,后面步骤一样。自己的歌版权清楚,发出去不用担心;长歌拆多段项目更稳,母带修剪好。长歌也建议切副歌试,跑通了补主歌。