AI唱歌動畫怎麼做影片?歌詞分鏡加數字人唱歌出片
更新時間:2026-11-16 17:00:00 釋出時間:15小時前 閱讀:8 views次AI唱歌動畫怎麼做影片?核心是歌詞分鏡加數字人唱歌:貼歌詞、選風格、點生成歌曲,識別字幕對齊時間,定人物場景、逐鏡出圖,影片段選數字人唱歌,末了合成匯出。前三步定像不像 MV,後三步定唱得對不對,口型跟字幕走。
開啟AI唱歌動畫工具,歌詞、分鏡、數字人唱歌都在同一個專案裡,做完直接合成出片。
歌詞結構與鏡頭節奏對齊
AI唱歌動畫的歌詞按鏡頭寫
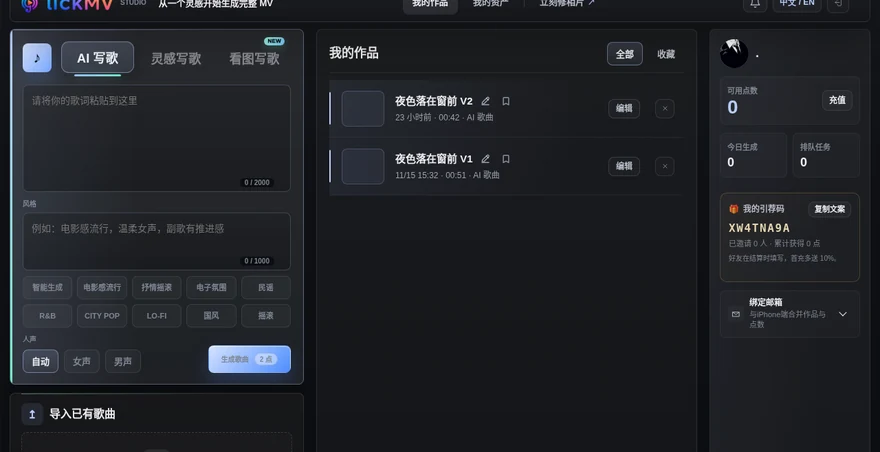
歌詞框容 2000 字,看著寬,實際只夠一首完整歌。寫的時候按鏡頭切:一句詞一個畫面,句子長度就是鏡頭長度。七到十二字一句,四到八句一段,主歌鋪陳,副歌收。寫抽象情緒,分鏡階段沒有畫面可拆;寫具體動作和場景,每一句都能落成鏡頭。
生成和匯入,選一個入口
生成:歌詞貼進去,風格框補 1000 字以內的曲風和人聲描述,人聲挑自動、女聲或男聲,點生成歌曲。匯入:MP3、AAC、WAV、FLAC、M4A 都收,提交後免費識別字幕。生成耗點數,匯入不耗,聲音已經有就用匯入。
字幕時間軸決定口型同步
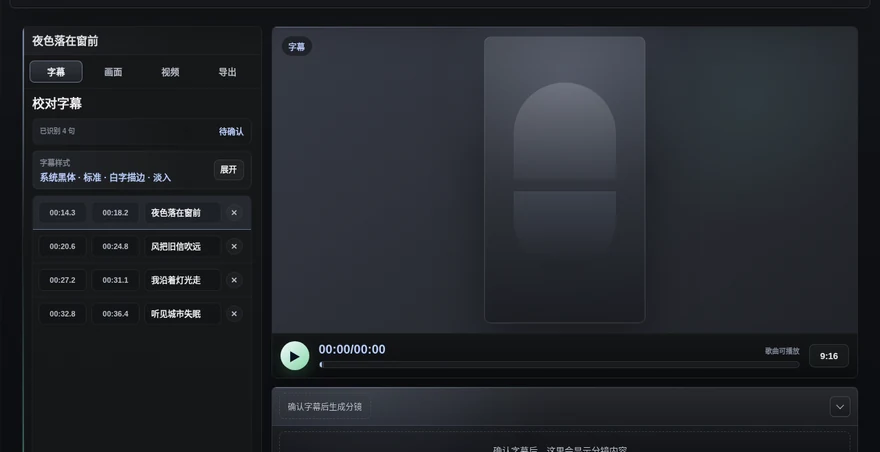
歌進專案後,系統跑一遍識別,把每句詞按起止時間排進字幕欄。字幕錯位,後面口型全跟著錯。錯字改掉,一句太長拆兩句各填時間,漏句補上。句子邊界對不上鼓點,會跳字。時間軸精確到 0.1 秒,例 00:14.3 到 00:18.2,手填別寫整秒。
樣式只動四組引數
字型、大小、描邊、入場四組。字選系統黑體,描邊白字加暗邊,入場用淡入。其餘引數不要動,跳字、旋轉、花體在大屏和豎屏都會糊。樣式定完全片統一,單句改樣式,成片會閃。
分鏡階段鎖定人物與場景
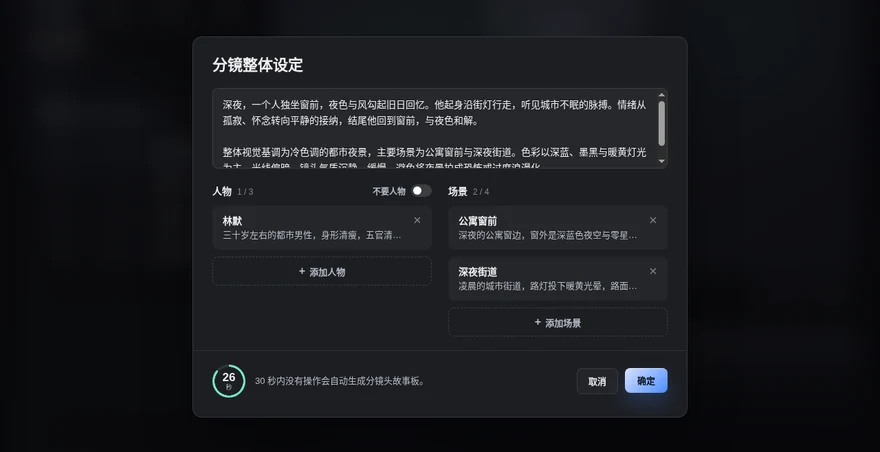
確認字幕會彈分鏡設定,要兩樣東西:人物和場景。人物三格,場景四格,還有一段按歌詞生成的劇情概述。這段概述是自己改的,不是模型改的,改完點確定,30 秒不動會自動按預設生成故事板。
人物三格寫什麼
年齡、身形、衣著、氣質,四樣寫全。例:三十歲上下的都市男性,身形清瘦,深灰針織衫配黑褲,氣質沉靜。寫死這四樣,每個鏡頭的臉才一致;只寫“一個男人”,十張圖能出十個臉。
場景四格寫什麼
時間、地點、光源、氛圍。深夜、公寓窗前、暖黃檯燈、安靜。場景不用多,兩三個夠了,同一場景在不同鏡頭裡複用,觀眾才認得出是同一支 MV 的同一個夜晚。
逐鏡出圖的角色一致性控制
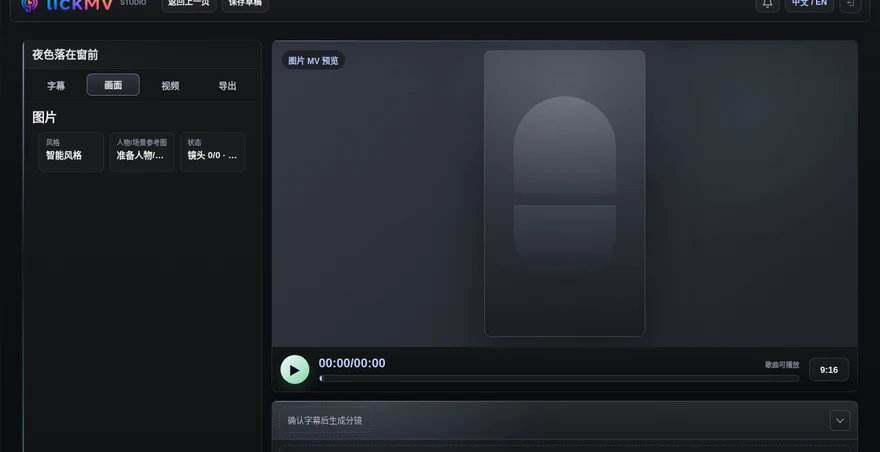
畫面定 AI唱歌動畫的成片像不像 MV,按分鏡一鏡一圖。風格掛智慧風格;人物參考圖掛正臉半身,場景參考圖掛主場景,同一場景的多鏡只掛一次。狀態列顯示鏡頭數和提示詞數,對不上就補。出圖盯小圖,糊了單張重生成,人物臉跑了就換參考圖重掛。
AI唱歌動畫的數字人檔位取捨
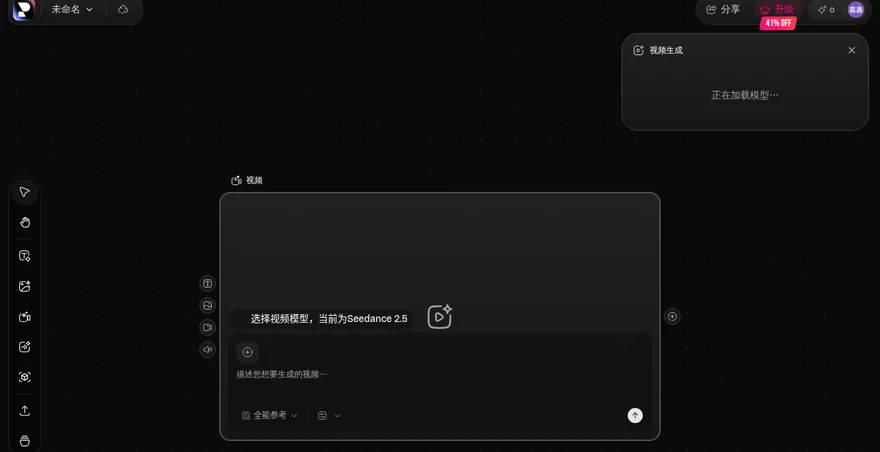
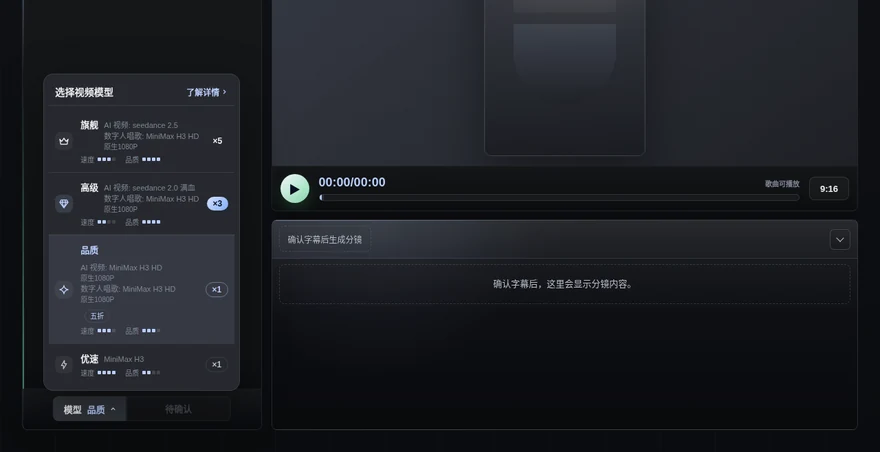
影片步驟開頭選模型,四檔都寫明瞭帶不帶數字人唱歌。旗艦檔:影片 seedance 2.5,唱歌 MiniMax H3 HD,五倍點;高階檔:seedance 2.0 滿血,三倍點;品質檔:MiniMax H3 HD,五折。
口型對不上的三個原因
- 字幕時間軸錯位,回去改字幕
- 人物嘴部被手、頭髮、話筒擋住
- 鏡頭是大側臉,嘴部畫素不夠
成片合成與工程匯出
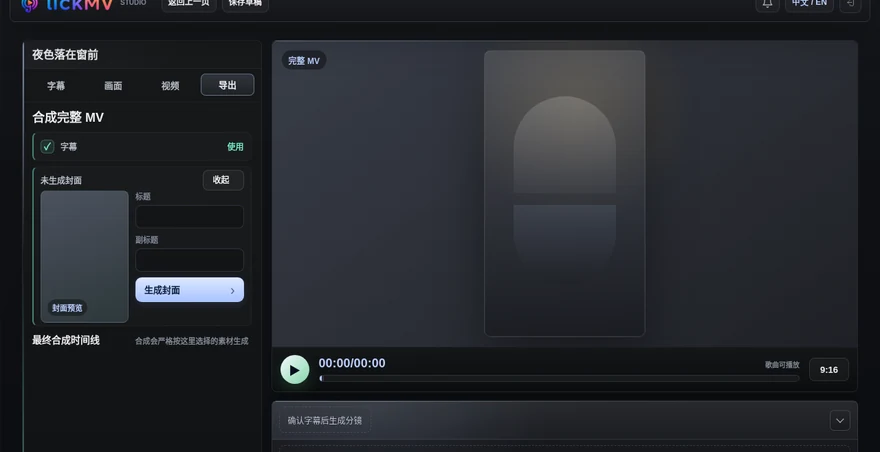
匯出步驟排最終時間線:字幕勾使用,時間線按歌詞順序核一遍,點生成完整 MV 等合成。封面要單獨生成,填標題和副標題,點生成封面,標題別太長,豎屏主圖字超過兩行會被裁。要自己改,下載剪映工程,字幕和軌道都在。
AI唱歌動畫常見問題
AI唱歌動畫的歌詞和分鏡怎麼對上
一句詞一個鏡頭。寫詞時定好三幕:開頭鋪場景,中段推進,結尾收情緒。句子超過十二字就拆,拆完每句還能落成一個畫面,分鏡就不會缺鏡頭。三幕分好,鏡頭數就定了,別邊寫邊改結構。
AI唱歌動畫口型對不上怎麼辦
字幕對不上,換正臉也白搭。查時間軸,查遮擋和角度。字幕錯位是主因,改完字幕要重新生成影片段;嘴被擋住或大側臉,換正臉頭肩景重出。整段都對不上,把那段拆成兩句單獨生成。
AI唱歌動畫一首歌要多久
40 秒的歌,字幕幾分鐘,分鏡十幾秒出,畫面按鏡頭數排隊,影片段按句數排隊,半小時上下。畫面和影片段都扣點數,一條 4 秒至少 1 點,試一段能過,才鋪全片。
AI唱歌動畫能用自己的歌嗎
能。匯入已有歌曲,提交後免費識別字幕,後面步驟一樣。自己的歌版權清楚,發出去不用擔心;長歌拆多段專案更穩,母帶修剪好。長歌也建議切副歌試,跑通了補主歌。